
Сопроцессор Intel® Xeon Phi
Уже год как Intel представила первое поколение сопроцессоров Xeon Phi. Что же это за зверь? Давайте разберемся.
Со слов википедии Xeon Phi - ребрендинг имплементации технологии Intel MIC (англ. Intel Many Integrated Core Architecture), архитектура многоядерной процессорной системы, разработанная Intel с использованием наработок архитектур Larrabee, Teraflops Research Chip, Intel Single-chip Cloud Computer.
В 2013 году вышло второе поколение - в максимальной конфигурации сопроцессоры Xeon Phi 7120P/7120X оперируют 61 ядром, обрабатывающим данные в 244 потока и работающим на частоте 1,23/1,33 ГГц (обычный режим/турбо).
Предложение звучит особенно заманчиво для разработчиков многопоточных приложений и всяких там кластерных вычислений, учитывая, что Xeon Phi - "карточка" шины PCI-Express. Взял Xeon, добавил пару Phi-карт и сделал себе суперкомпьютер. Добавим к этому пару крупных компаний, выпускающих готовые решения, - SuperMicro, Dell - и можно, казалось бы даже, выйти в Production.
Рассмотрим главный вопрос - что собственно достается разработчику? Читаем Quick Start Guide с сайта Intel:
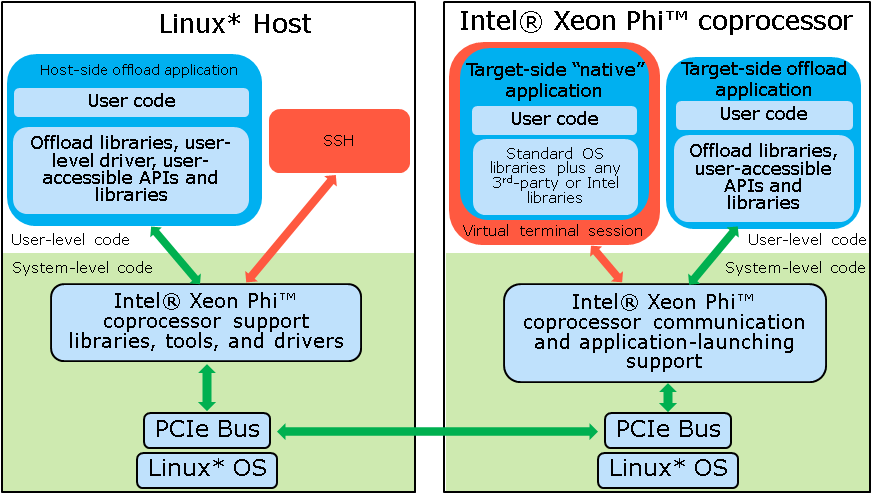
Итак:
- Берем RHEL 6 (ядро не ниже 2.6.32-131) или SLES 11 (ядро не ниже 3.0.13-0.27) - и, похоже, больше из OS ничего не подойдет
- Ставим последние драйвера с Intel, обновляем Flash на самом Phi
- Запускаем сервис mpss
- Покупаем или закачиваем бесплатно компоненты Software Development Tools, устанавливаем
- Проверяем "тестовым" (/opt/intel/composerxe/Samples/en_US/C++/mic_sample), что карточка(и) работают корректно
- Опционально включаем сбор статистики производительности
- Проверяем статус (/opt/intel/mic/bin/micsmc)
- Готовы к работе
Интересным мне показался комментарий - "если ваш(и) Phi завис(ли) или не работает(ют), остановите, выгрузите и запустите сервис mpss".
Как же собственно "добраться" до сопроцессора?
Путь №1 меня несколько удивил: зайдите по SSH и можете выполнять "many common Linux commands". Соответственно, передача файлов по "scp".
IP-шники назначаются так: 172.31.<coprocessor>.254, или как алиас-хосты mic<coprocessor>. Собс-но:
weinberg@knf1:~> ssh mic0
[weinberg@knf1-mic0 weinberg]$ hostname
knf1-mic0
[weinberg@knf1-mic0 weinberg]$ cat /etc/issue
Intel MIC Platform Software Stack release 2.1
Kernel 2.6.34.11-g65c0cd9 on an k1om
Возникает вопрос - зачем до него добираться? Оказывается, мы можем выполнить (ssh) наш скомпилированный бинарник прямо внутри Phi, предварительно туда его закачав (scp).
Путь №2 через соответствующие бинарники mic* из пакета драйверов.
Наконец-то дошли до разработки - нам доступны:
- Compilers
- Intel C++ Composer XE 2013 for building applications that run on Intel® 64 architecture and Intel® MIC Architecture
- Intel® Fortran Composer XE 2013 for building applications that run on Intel® 64 architecture and Intel® MIC Architecture
- Libraries packaged with the compilers include:
- Intel® Math Kernel Library (Intel® MKL) optimized for the Intel® MIC Architecture
- Intel® Threading Building Blocks (Intel® TBB)
- Intel® Integrated Performance Primitive (Intel® IPP)
- Libraries packaged separately include:
- Intel® MPI for Linux* OS including Intel® Many Integrated Core (Intel® MIC) Architecture
- Intel® Trace Collector and Analyzer
- Intel® SDK for OpenCL* Applications XE 2013 available at: http://software.intel.com/en-us/vcsource/tools/opencl-sdk-xe
С кучей флагов компилятора, линкера и окружения для собственно запуска.
Собственно код:
float reduction(float *data, int size) {
    float ret = 0.f;
    for (int i=0; i<size; ++i) {
        ret += data[i];
    }
    return ret;
}
Оптимизируется до:
float reduction(float *data, int size) {
    float ret = 0.f;
    #pragma offload target(mic) in(data:length(size))
    for (int i=0; i<size; ++i) {
        ret += data[i];
    }
    return ret;
}
Или даже до:
float reduction(float *data, int size) {
    float ret = 0;
    #pragma offload target(mic) in(data:length(size))
    ret = __sec_reduce_add(data[0:size]); //Intel® Cilk™ Plus Extended Array Notation
    return ret;
}
Возникает вопрос - собственно, какого ускорения ожидать? Чисто логически, на том же Xeon Phi 7120P/7120X, который оперирует 61 ядром и обладает, видимо, еще и группой конвейеров на каждом ядре, ускорение на сложении должно быть никак не менее, чем в 61 раз (Кэп, привет!).
Помимо "ускорения" сложения массивов присутствует настоящая поддержка многопоточности для "числодробления" и много чего еще, включая OpenMP. Также радует возможность написания кода, работающего и с Phi, и без Phi.
Чего собственно, IMHO, не хватает?
- Поддержки Java и "других языков" вкупе со сниппетами и, возможно, фреймворками (а не только C/C++ и Fortran)
- Поддержки не-Linux OS
P.S. Отдельный вопрос цены "минимальной карточки" за 100 кило-рублей оставим за рамками этого обзора.
P.P.S. Прямой конкурент Phi - Nvidia Tesla
Впервые опубликовано в ЖЖ.