
ELK 5.X
Этой записью открываю серию заметок на тему использования Elasticsearch 5.X для агрегации и поиска. Сайт - https://www.elastic.co
Дам свое определение стеку ELK - Elasticsearch Logstash Kibana (+Beats):
- Elasticsearch - нереляционная БД (хранящая т.н. документы), оптимизированная для поисковых запросов (как выборок документов, так и агрегационных функций). Платформа - Java. Поисковое ядро - Apache Lucene. Горизонтально масштабируется из коробки. REST и прочее API присутствует.
- Logstash - дата-коллектор с парадигмой input => filter => output. Input-ом может быть file, jdbc, http, exec, kafka, log4j, s3 и проч. (более 30 типов). Output-ом file, elasticsearch, kafka, tcp и даже jira (тоже более 30 типов). Платформа JRuby.
- Beats - легковесный, упрощенный, нативный вариант Logstash (а-ля агент), который может передавать данные как в сам Logstash (для фильтрации), так и напрямую в Elasticsearch.
- Kibana - визуализатор содержимого Elasticsearch. Платформа NodeJS.
Как это выглядит:
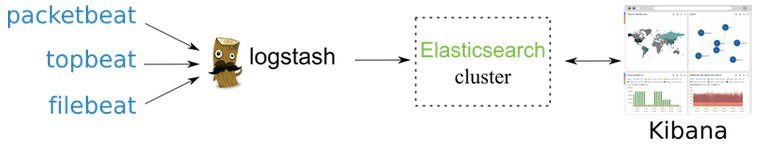
Для чего можно использовать ELK:
- Агрегация инфраструктурных логов и поиск/анализ в логах
- BI - выгрузка и анализ большого объема данных из произвольного источника
- Мониторинг инфраструктуры.
Впервые опубликовано в ЖЖ.